

- 하나의 모델에서 생성과 편집: 동일한 가중치가 텍스트 기반 이미지 생성 프롬프트와 편집 지시를 모두 처리하므로, 워크플로에서 체크포인트를 교체할 필요가 없습니다
- 네이티브 2K 출력: 더 작은 결과를 업스케일링하는 대신 최대 2048x2048로 직접 생성합니다
- 전문적인 타이포그래피: 인포그래픽, 슬라이드, UI 목업, 포스터, 패키징 디자인에서 촘촘한 작은 텍스트와 복잡한 레이아웃이 유지됩니다
- 알파 채널 지원: VAE가 4개 채널을 가지므로 투명 배경 이미지를 나중에 잘라내는 대신 직접 생성하고 편집할 수 있습니다
- 다중 이미지 편집: 참조 이미지는 슬롯 순서대로 텍스트 인코더에 이어 붙습니다. Text Encode Qwen Image 2.1 노드는 최대 16개 슬롯(
image_1부터image_16까지)을 지원하며, 이 페이지의 편집 템플릿 2개는 처음 10개(image_1부터image_10까지)를 연결합니다.image_1은 편집 대상 이미지이고 나머지는 내용을 보충합니다. 프롬프트는 인덱스로 각 이미지를 지정합니다. 예를 들어image_1은<image1>로 작성합니다 - 국소 편집: 변경할 객체나 영역을 설명하면 이미지의 나머지 부분은 그대로 유지됩니다
Qwen-Image-2.1 워크플로
Qwen Image 2.1 텍스트 기반 이미지 생성
선택한 화면 비율과 메가픽셀 목표에 맞춰 텍스트 프롬프트로 이미지를 생성합니다.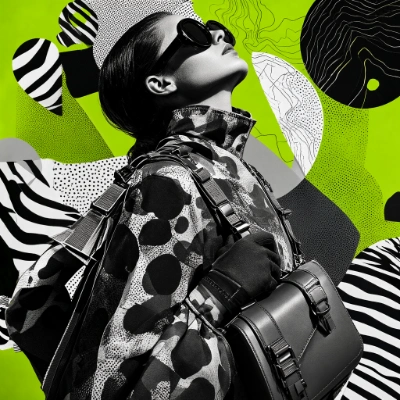
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “Qwen-Image-2.1”을 검색하세요
Comfy Cloud에서 실행
복잡한 설정 없이 온라인에서 ComfyUI를 실행하세요
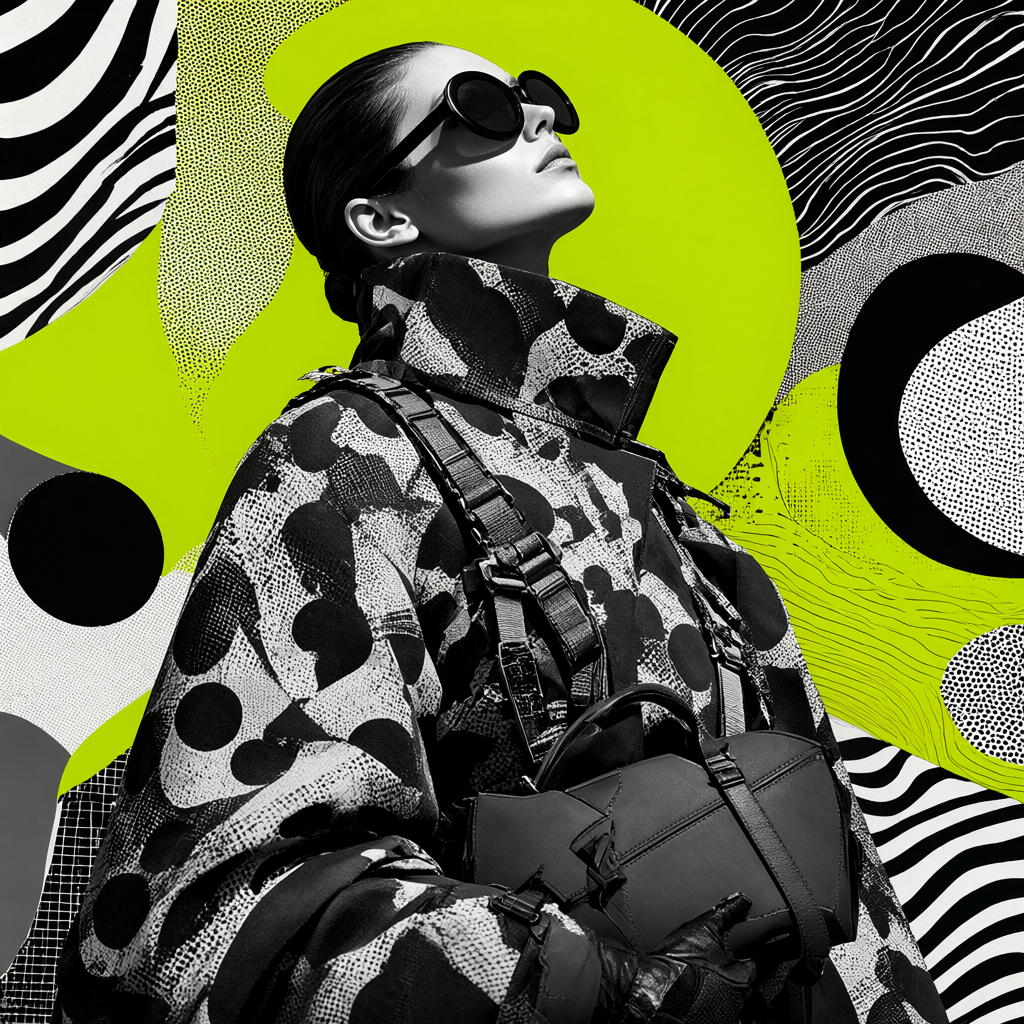
Qwen Image 2.1 이미지 편집
지시문으로 이미지를 편집합니다. 소스 이미지에 없는 콘텐츠가 편집에 필요할 때는 참조 이미지를 추가하세요. 예를 들어 두 번째 사진의 의상을 첫 번째 사진 속 인물에게 입히는 경우입니다.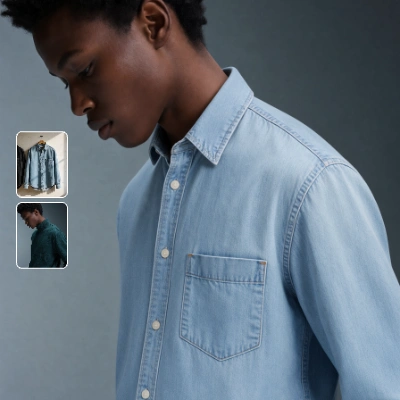
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “Qwen-Image-2.1”을 검색하세요
Comfy Cloud에서 실행
복잡한 설정 없이 온라인에서 ComfyUI를 실행하세요
LoadImage 노드에 업로드하세요:
portrait_model_denim.png
LoadImage 노드 470 · portrait_model_denim.pngclothing_light_blue_denim_shirt.png
LoadImage 노드 475 · clothing_light_blue_denim_shirt.png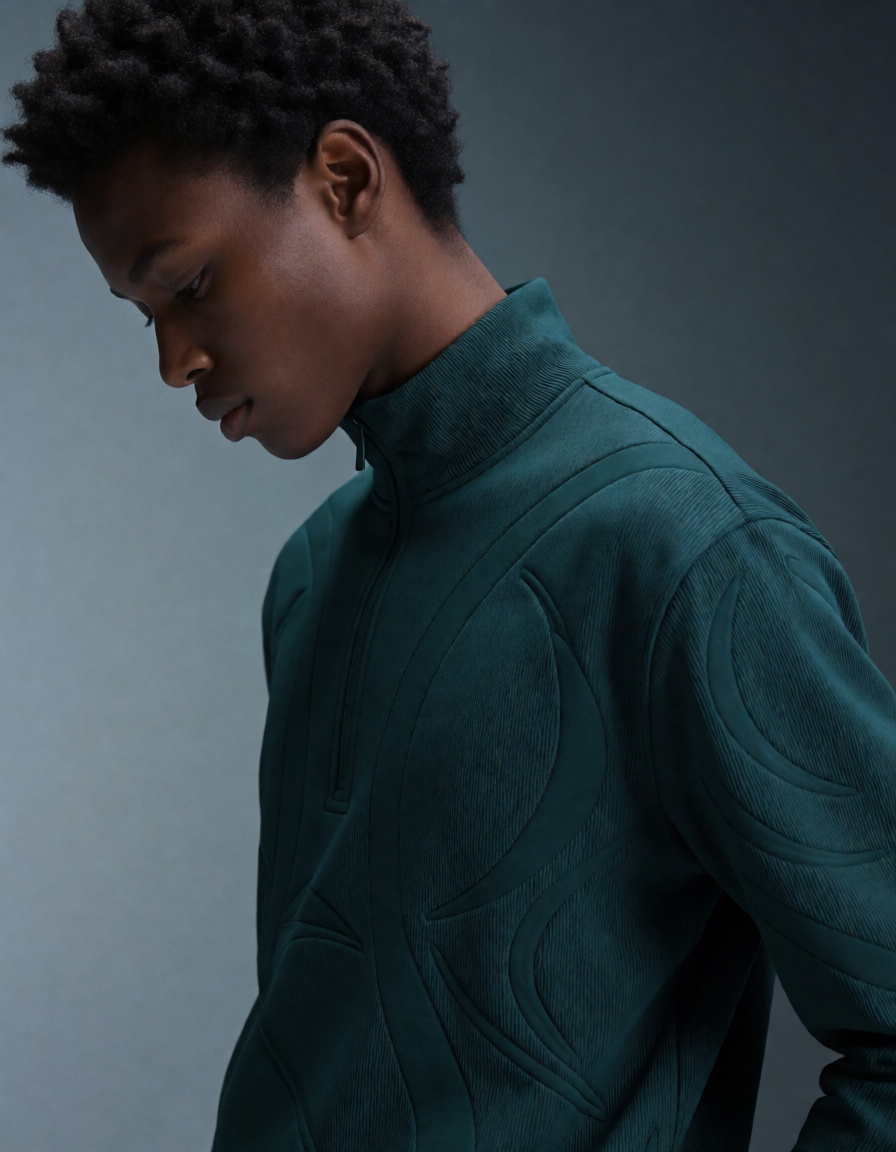
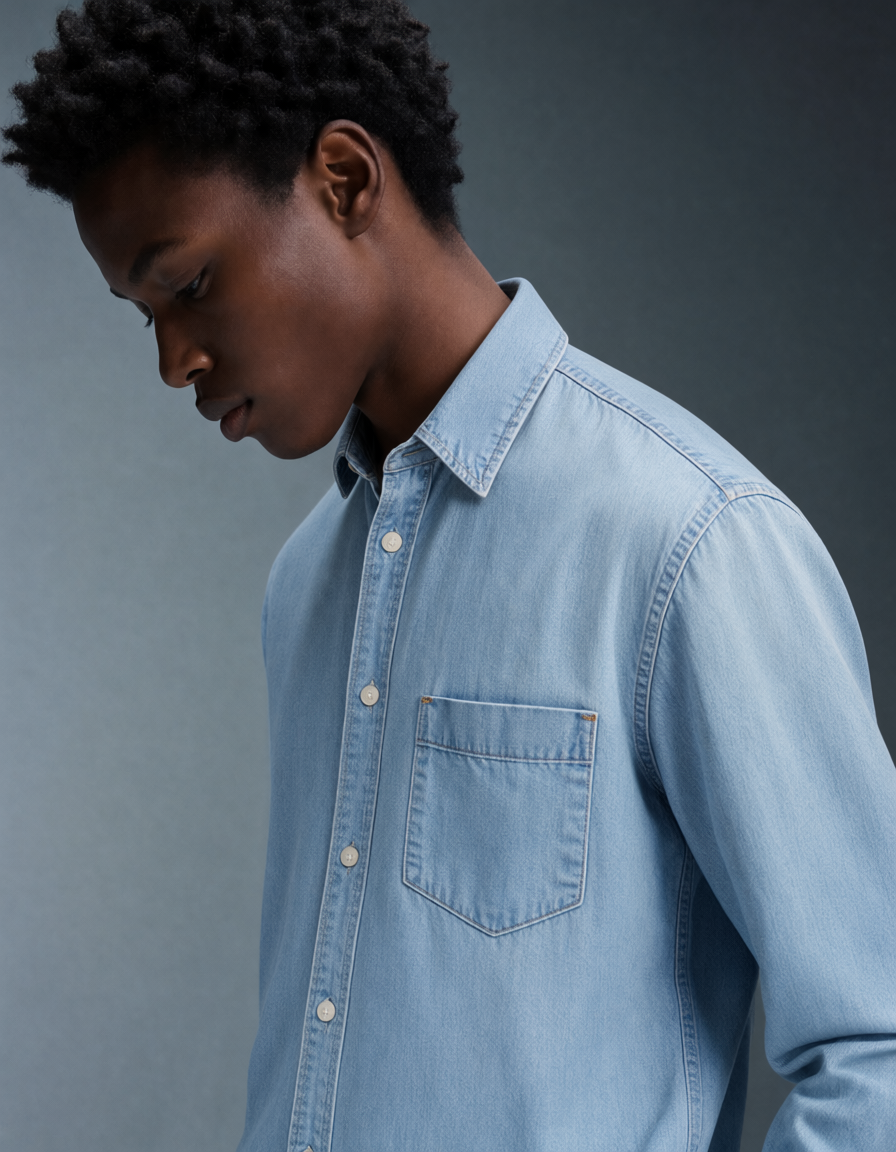
배경 제거: Qwen Image 2.1
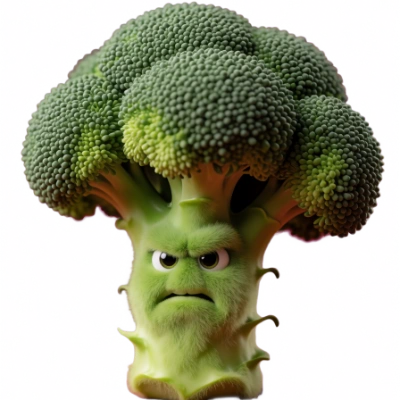
편집 지시로 사진의 배경을 제거합니다. 이 워크플로는 이미지 편집 서브그래프를 재사용하며, 프롬프트는Remove the background, and output a PNG image입니다. 결과는 원본 이미지와 비교할 수 있습니다.
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “Qwen-Image-2.1”을 검색하세요
Comfy Cloud에서 실행
복잡한 설정 없이 온라인에서 ComfyUI를 실행하세요
LoadImage 노드에 업로드하세요:
angry_broccoli.png
LoadImage 노드 470 · angry_broccoli.png모델 링크
세 워크플로는 diffusion 모델, VAE, 기본 텍스트 인코더를 공유합니다. 텍스트 기반 이미지 생성과 이미지 편집 템플릿은 각각 프롬프트 향상용 텍스트 인코더를 추가로 불러옵니다. 텍스트 기반 이미지 생성은qwen3.5_9b_qwen_image_2.1_pe_t2i, 이미지 편집은 qwen3.5_9b_qwen_image_2.1_pe_i2i를 사용합니다.
text_encoders
- qwen3vl_8b_int8_convrot.safetensors (템플릿이 기본으로 불러오며 메모리 사용량이 더 적습니다)
- qwen3vl_8b_bf16.safetensors (전체 정밀도, 더 많은 메모리가 필요합니다)
- qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors (텍스트 기반 이미지 생성 템플릿의 프롬프트 향상)
- qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors (이미지 편집 템플릿의 프롬프트 향상)
- qwen_image_2.1_int8_convrot.safetensors (템플릿이 기본으로 불러오며 메모리 사용량이 더 적습니다)
- qwen_image_2.1_bf16.safetensors (전체 정밀도, 더 많은 메모리가 필요합니다)
워크플로 설정
샘플러 설정
세 워크플로 모두steps 25, cfg 1, euler 샘플러, simple scheduler로 샘플링합니다.
cfg가 1이면 ComfyUI가 네거티브 조건 계산을 건너뛰므로, 이 워크플로에서는 네거티브 프롬프트가 아무 효과도 없습니다. 템플릿은 Qwen-Image-2.1이 공개된 경로인 cfg 1을 유지하며, 네거티브 프롬프트를 적용하고 싶을 때만 값을 올리세요. cfg 2는 작은 텍스트와 숫자를 포함한 복잡한 프롬프트를 더 잘 따르지만, 그 대신 가장자리가 과도하게 선명해집니다. 그보다 더 올리면 노출이 밝거나 어두운 쪽으로 치우치고, cfg 5는 품질을 크게 떨어뜨리며, cfg 0.5는 이미지를 망가뜨립니다. 한 번에 하나씩만 바꾸고 고정 시드로 비교하세요.
steps는 두 번째 조정 항목입니다. Qwen-Image-2.1의 공개 파이프라인은 euler 샘플러와 약 40steps는 특정 부분이 도저히 수렴하지 않을 때만 조정하세요.
해상도
텍스트 기반 이미지 생성: 해상도 선택기 노드가 화면 비율과 메가픽셀 목표값을 설정하며, 여기서 1.0 MP는 약 1024x1024입니다. Qwen-Image-2.1은 2K로 네이티브 생성하므로, 2048x2048 정사각형 출력에는 목표값을 약 4.0 MP로 설정하세요. 이미지 편집: 캔버스는 Image Edit 서브그래프 노드의resolution 컨트롤로 결정됩니다(범위 0부터 4096까지, 단계 32). 노드 자체의 기본값은 1024이고 템플릿은 0으로 배포됩니다. 템플릿 기본값인 custom_size 끄기 상태에서는 편집이 첫 번째 참조 이미지 image_1의 크기로 생성됩니다:
resolution이0이면 각 참조 이미지가 자체 픽셀 크기(32의 배수로 반올림)를 유지하므로 3000x4000 사진은 3008x4000 캔버스가 됩니다resolution이0보다 크면image_1의 화면 비율을resolutionxresolution픽셀 예산에 맞춰 조정합니다. 이는 너비나 높이가 아니라 총 픽셀 수이며 32의 배수로 반올림되므로, 같은 사진에서resolution1024는 약 896x1184가 됩니다
custom_size를 켜고, 크기를 조정된 image_1 크기에 가깝게 유지하세요. 그렇지 않으면 편집 결과가 어긋날 수 있습니다.
비용을 결정하는 것은 캔버스 크기입니다. 3000x4000 참조 이미지는 resolution이 0일 때 3008x4000(약 12 MP)에서 샘플링되고, 같은 편집을 resolution 1024로 설정하면 약 896x1184(약 1 MP)가 됩니다. RTX 5090에서는 약 6 s/it과 약 0.3 s/it의 차이입니다. resolution을 낮추면 더 작은 결과를 생성해 빨라지는 것이며 세부 묘사가 늘어나는 것은 아닙니다. 편집이 느리게 느껴진다면 다른 설정을 건드리기 전에 resolution과 참조 이미지의 픽셀 크기를 확인하세요. 큰 참조 이미지를 여러 장 쓰면 더 느려지며, 이 비용에는 아래의 KV 캐시 설정이 영향을 줍니다. 또한 모델의 2K 학습 크기를 크게 넘는 목표값(예: 4K)은 프롬프트 준수도가 떨어집니다.
이미지 편집 프롬프트 작성
참조 이미지는 슬롯 순서대로 텍스트 인코더에 삽입되며, 프롬프트는 각 이미지를 인덱스로 지칭합니다:image_1을 공급하는 LoadImage 노드(노드 470: 노드를 우클릭한 뒤 마스크 편집기에서 열기 선택)에서 Paint Pen으로 영역을 칠한 다음 저장하세요. Paint Pen은 마스크가 아니라 이미지의 RGB 레이어에 칠하므로, 저장하면 마크가 있는 이미지가 노드로 다시 기록되고 마크는 이 편집이 읽는 참조 이미지의 일부가 됩니다. 프롬프트에서 마크의 색을 지정하면 해당 영역으로 지시가 향합니다. 예: “빨간 영역의 재킷을 변경”. 마크는 변경할 영역 안에 두세요. 마크의 색이 결과에 나타나면 원하는 색도 프롬프트에 함께 적으세요.
KV 캐시
편집 워크플로에는 Qwen Image 2.1 Cache 노드가 포함되어 있으며, 샘플링 단계 사이에 캐시된 텍스트와 참조 프리픽스를 유지합니다. 템플릿 기본 설정은 대부분의 환경에서 그대로 사용할 수 있습니다. 이 노드는 실험적 기능이며 두 가지 컨트롤을 제공합니다:프롬프트 향상
텍스트 기반 이미지 생성과 이미지 편집 템플릿에는 선택적 프롬프트 향상 단계가 포함되어 있습니다. 전용 텍스트 인코더가 샘플링 전에 프롬프트를 다시 작성하여, 짧은 요청을 더 자세한 설명으로 확장합니다. 두 템플릿 모두 Qwen Image 2.1 서브그래프 노드에서 다음 컨트롤을 제공합니다:refine_prompt: 두 템플릿 모두 기본값은 꺼짐입니다. 켜면 이미지 모델이 입력한 프롬프트 대신 다시 작성된 프롬프트로 샘플링합니다PE_model: 다시 작성을 수행하는 텍스트 인코더입니다. 텍스트 기반 이미지 생성은qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors, 이미지 편집은qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors를 사용합니다thinking_mode: 두 템플릿 모두 기본값은 꺼짐입니다.refine_prompt와 함께 켜면 다시 작성 모델이 출력 전에 추론합니다
refine_prompt가 켜져 있을 때만 실행되므로 향상용 텍스트 인코더는 두 템플릿 모두 선택 사항이며, 사용하려면 refine_prompt를 켜면 됩니다. 배경 제거 템플릿에는 이 단계가 없습니다.